Gigerenzer, G. (1993). The superego, the ego, and the id in statistical reasoning. In G. Keren & C. Lewis (Eds.), A handbook for data analysis in the behavioral sciences: Methodological issues (pp. 311–339). Lawrence Erlbaum Associates.
Pourquoi lire ce texte ?
Le test de l’hypothèse nulle tel qu’il est enseigné et pratiqué en psychologie combine des éléments de deux théories statistiques incompatibles, celle de Ronald Fisher et celle de Jerzy Neyman et Egon Pearson, sans que cette combinaison soit signalée dans les manuels. Le chapitre de Gerd Gigerenzer (1993) retrace la manière dont cette combinaison s’est constituée entre 1940 et 1960, montre en quoi elle est incohérente du point de vue de chacune des deux théories, et décrit ses effets sur la pratique de la recherche. Plus de 30 ans après sa publication, cette logique hybride reste celle que l’on enseigne et que l’on applique.
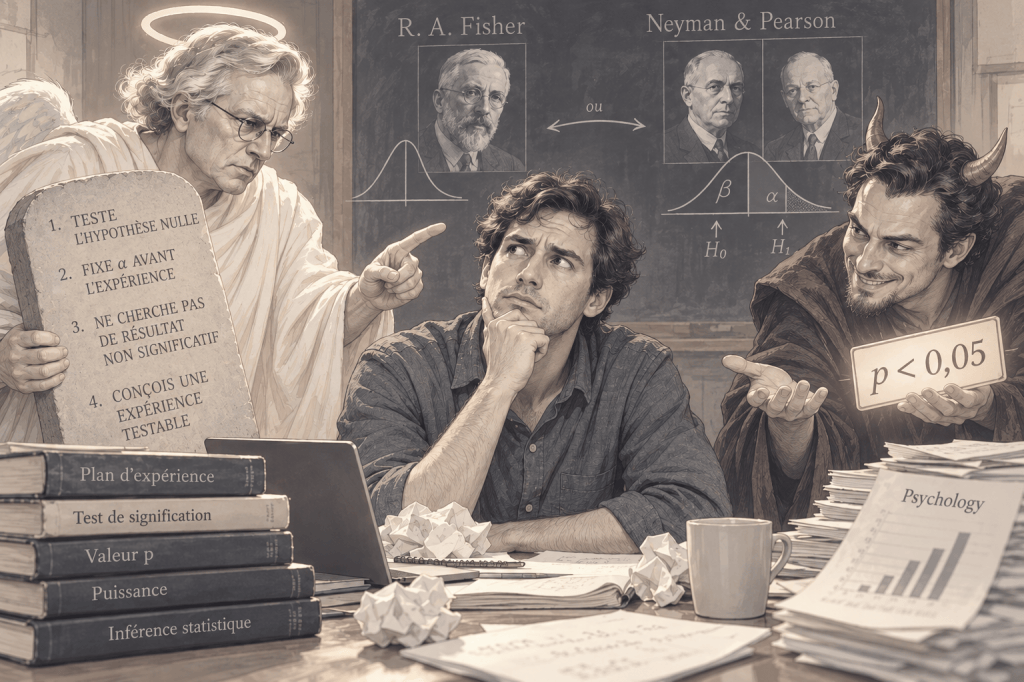
Gigerenzer ouvre son chapitre sur un constat. Les grandes découvertes de la psychologie de la première moitié du vingtième siècle ont été faites sans tester d’hypothèse nulle. Piaget a élaboré sa théorie du développement cognitif, Köhler les lois gestaltistes de la perception, Pavlov les principes du conditionnement classique, Skinner ceux du conditionnement opérant et Bartlett sa théorie du souvenir et des schémas sans rejeter d’hypothèse nulle. En 1969, lorsque l’auteur suit son premier cours de psychologie à l’université de Munich, le test de l’hypothèse nulle lui est pourtant présenté comme la condition sine qua non de la recherche scientifique. Cet enseignement possède une sorte de coloration morale digne des dix commandements.Tu ne tireras pas d’inférence d’un résultat non significatif. Tu fixeras toujours le seuil de signification avant l’expérience, et ceux qui le fixent après coup, en arrondissant la valeur p obtenue au seuil conventionnel le plus proche, trichent. Tu concevras toujours tes expériences de manière à pouvoir réaliser un test de signification.
Cette tonalité prescriptive, presque religieuse, annonce la thèse du chapitre : la manière dont la psychologie pratique l’inférence statistique relève moins d’un raisonnement que d’un rituel, chargé d’émotions, de culpabilité et d’interdits.
La révolution de l’inférence
En psychologie, les probabilités ont surtout servi à mécaniser les inférences des chercheurs, en particulier celles qui vont des données aux hypothèses. Gigerenzer et Murray ont appelé cette transformation la révolution de l’inférence (Gigerenzer & Murray, 1987). Entre 1940 et 1955 environ, elle a fait d’une forme particulière de statistique inférentielle la méthode de l’inférence scientifique, dans les cursus, les manuels et les politiques éditoriales. Rucci et Tweney (1980) ne trouvent que 17 articles utilisant le test de l’hypothèse nulle entre 1934 et 1940, alors qu’en 1955 plus de 80 % des articles empiriques de quatre revues majeures y recourent (Sterling, 1959). Gigerenzer estime que, sous de telles politiques éditoriales, les travaux de Piaget, Köhler, Bartlett, Pavlov et Skinner auraient probablement été refusés.
Skinner et Meehl ont imputé cet état de fait à Fisher. Pour Gigerenzer, c’est une erreur, puisque Fisher tenait lui-même le test de significativité pour un argument faible, applicable seulement lorsqu’on ne dispose de presque aucune connaissance. Ce qui s’est institutionnalisé n’est pas la statistique de Fisher, mais un mélange incohérent de certaines idées de Fisher et de certaines idées de Neyman et Pearson, que Gigerenzer appelle la logique hybride. Cette logique présente la statistique comme une structure unique, parlant d’une seule voix, et l’inférence inductive comme un problème doté d’une solution algorithmique valable dans tous les contextes. Dans l’épilogue du chapitre, Gigerenzer soutient enfin que les outils statistiques tendent à devenir des théories de l’esprit, et montre que le même dogme réapparaît dans la recherche sur le jugement en situation d’incertitude.
Fisher vs. Neyman et Pearson : deux logiques concurrentes
Fisher et Neyman et Pearson partagent une conception fréquentiste des probabilités. Leurs tests ne donnent que la probabilité des données sachant une hypothèse, et non la probabilité d’une hypothèse sachant les données, que seul le théorème de Bayes permet de calculer à condition de disposer d’une distribution a priori. Fisher rejetait cette approche comme subjective (Fisher, 1935). Sur tout le reste, les deux logiques s’opposent, et Gigerenzer précise que Fisher a lui-même modifié, parfois inversé, sa position au cours de la controverse.
Chez Fisher, on teste une seule hypothèse, l’hypothèse nulle, et l’on se demande si les données s’en écartent suffisamment pour la juger peu plausible. Le niveau de significativité est d’abord une convention commode (Fisher I), puis, dans ses derniers écrits, une valeur exacte déterminée après l’expérience et communiquée aux collègues (Fisher II). C’est une propriété des données, et un résultat significatif modifie notre degré de confiance dans la fausseté de l’hypothèse nulle, dans une expérience particulière. Un résultat non significatif ne permet pas d’établir l’hypothèse nulle, et la puissance n’a pas de sens, puisqu’aucune hypothèse alternative n’est formulée.
Chez Neyman et Pearson, on oppose deux hypothèses précises dont l’une est supposée vraie. Le seuil, alpha, est fixé avant l’expérience en fonction des coûts des deux erreurs possibles, et il désigne la fréquence à long terme avec laquelle on rejettera à tort l’hypothèse nulle dans des expériences répétées. C’est une propriété du test, pas des données. Un résultat, significatif ou non, ne dit rien de la vérité d’une hypothèse particulière : c’est une décision d’agir comme si l’une ou l’autre était vraie, sur le modèle du contrôle de qualité industriel1. L’erreur de seconde espèce et la puissance, c’est-à-dire la fréquence à long terme avec laquelle on accepte l’hypothèse alternative lorsqu’elle est vraie, en découlent.
Le terme « significativité » recouvre donc trois sens incompatibles : un seuil conventionnel (Fisher I), une valeur p exacte (Fisher II), et une fréquence d’erreur fixée à l’avance (Neyman et Pearson). Fisher reprochait à Neyman et Pearson de confondre la production de connaissances avec la technologie, et Neyman reprochait à Fisher d’appliquer mécaniquement le seuil de 1 %. Gigerenzer en conclut que les deux camps s’accordaient au moins sur un point : l’inférence statistique ne doit pas être automatique.
Le Surmoi, le Moi et le Ça de l’inférence statistique
Les manuels de psychologie des années 1940, à commencer par celui de Guilford (1942), ont d’abord enseigné le test de Fisher en l’interprétant en termes bayésiens, transformant la probabilité des données sachant une hypothèse, P(D|H), en probabilité de l’hypothèse sachant les données, P(H|D). Dans les années 1950 et 1960, leurs successeurs y ont greffé les concepts de Neyman et Pearson sans les nommer. De ce mariage forcé, selon l’expression de Gigerenzer, naît la logique hybride, qui dissimule son origine. Pour décrire les tensions que suscite cette logique, Gigerenzer développe une analogie freudienne suggérée par Acree (1978).
La logique de Neyman et Pearson fonctionne comme le Surmoi. Elle exige de spécifier à l’avance des hypothèses alternatives précises, un seuil de significativité et une puissance, afin de calculer la taille d’échantillon nécessaire. Elle interdit les énoncés épistémiques sur des résultats particuliers, et en particulier l’interprétation du niveau de significativité comme degré de confiance dans la vérité ou la fausseté d’une hypothèse.
La logique de Fisher fonctionne comme le Moi. Le Moi fait avancer le travail au laboratoire et permet de publier. Il détermine le niveau de significativité après l’expérience, ne spécifie pas la puissance et ne calcule pas la taille d’échantillon. Il ne formule pas les prédictions exactes de l’hypothèse de recherche, mais revendique un soutien pour celle-ci dès qu’il rejette une hypothèse nulle, et il produit des énoncés épistémiques sur des résultats particuliers. Le conflit entre les deux instances se manifeste dans le compte rendu des résultats. Les éditeurs et les auteurs de manuels ayant fait du niveau de significativité une mesure de la qualité de la recherche, le Moi arrondit après coup la valeur p obtenue au seuil conventionnel le plus flatteur, par exemple en présentant une valeur de 0,6 % comme significative au seuil de 1 %. Le Surmoi exige au contraire que ce résultat soit rapporté au seuil de 5 % si c’est ce seuil qui avait été fixé avant l’expérience. Le Moi l’emporte le plus souvent, avec un sentiment de malhonnêteté et de culpabilité.
Censurés à la fois par le Surmoi fréquentiste et par le Moi pragmatique, les énoncés portant sur la probabilité des hypothèses sachant les données forment le Ça bayésien. Une mesure directe de la validité des hypothèses est, selon Gigerenzer, ce que les chercheurs désirent réellement, et ce désir se manifeste dans leurs intuitions. Parmi 70 universitaires interrogés par Oakes (1986), 96 % croyaient que le niveau de significativité indique la probabilité que l’hypothèse nulle, ou l’hypothèse alternative, soit vraie. La composante fréquentiste de l’hybride produit une illusion comparable : 60 % pensaient qu’un résultat significatif au seuil de 1 % le serait de nouveau dans 99 % des réplications, alors que ni alpha ni la valeur p ne renseignent sur la probabilité de réplication. Ces intuitions exagèrent toutes ce que l’on peut inférer d’une valeur p.
L’analogie suggère que la confusion des chercheurs, des éditeurs et des auteurs de manuels ne tient pas à un manque d’intelligence. Tout se passe comme si les conflits entre Fisher et Neyman et Pearson, et entre ces fréquentistes et les bayésiens, avaient été projetés en un conflit intrapsychique dans l’esprit des chercheurs, et comme si le déni de ce conflit avait produit des distorsions émotionnelles, comportementales et cognitives. La plus visible est un comportement mécanique, que Gigerenzer compare au lavage compulsif des mains. L’hypothèse nulle est presque toujours une hypothèse d’effet nul, les hypothèses alternatives précises sont rarement énoncées, et la taille d’échantillon est rarement calculée en fonction d’une puissance souhaitée. La puissance reste ainsi inférieure à 50 % pour un effet de taille moyenne (Cohen, 1962), et elle n’avait pas augmenté 25 ans plus tard (Sedlmeier & Gigerenzer, 1989)2.
Ce rituel a eu ses bénéfices : il a facilité l’administration de la recherche et les décisions des éditeurs, et il a réduit le jugement informé à un schéma que presque n’importe qui peut apprendre. Il procure surtout une illusion d’objectivité, que la logique hybride ne pouvait entretenir qu’en niant ses origines et les conflits entre ses géniteurs. Gigerenzer admet que le risque de distorsion subjective des données existe, mais il estime qu’on ne le corrige pas en remplaçant les distorsions individuelles par une distorsion collective.
Et aujourd’hui ?
Gigerenzer termine son chapitre en refusant de remplacer un dogme mécanique par un autre. Trente ans plus tard, la réponse de la discipline à la crise de la réplication invite à relire cette mise en garde. Le préenregistrement demande de fixer avant l’expérience les hypothèses, le seuil et la taille d’échantillon, et de nombreuses revues exigent désormais de justifier cette dernière. Autrement dit, les exigences du Surmoi neyman-pearsonien, restées lettre morte pendant un demi-siècle, deviennent des procédures institutionnelles. Or une règle peut être appliquée sans le jugement qu’elle suppose : une analyse de puissance fondée sur une taille d’effet conventionnelle, faute de savoir quel effet compterait, satisfait l’exigence du Surmoi sans répondre à la question qu’elle pose.
On peut voir dans ces procédures un progrès. On peut aussi se demander si la discipline ne répond pas de nouveau à une crise méthodologique par davantage de règles. Si tel est le cas, le problème que décrit Gigerenzer ne relève pas seulement de la statistique, et une réforme procédurale, même bien conçue, ne suffira pas à le résoudre. Le chapitre rappelle qu’aucune procédure, aussi sophistiquée soit-elle, ne dispense du jugement.


Laisser un commentaire